Метод исследования данных, который позволяет оценить вклад каждого входного признака в конечный результат. Целью при этом служат снижение размерности задачи за счет исключения признаков, имеющих низкую значимость, а также улучшение понимаемости данных и построенных на них моделей.
Количество признаков, описывающих тот или иной бизнес-процесс, на практике может оказаться очень большим — от нескольких десятков до нескольких сотен. Поэтому аналитические модели часто становятся слишком сложными и содержат много переменных. В результате резко возрастают алгоритмическая и вычислительная сложность модели, а также затраты на ее разработку и практическое использование.
Кроме этого, возникают проблемы с пониманием работы модели и интерпретацией результатов. Поэтому в предсказательном моделировании актуальна задача сокращения числа переменных модели без значительного снижения ее точности.
В общем виде задачу можно сформулировать так: если исходные данные содержат, скажем, 10 входных признаков, которые выражают всю необходимую информацию об анализируемом бизнес-процессе, то нельзя ли сократить их число, например, до 5 без значимой потери информативности? И чтобы модель, которая будет построена на таких редуцированных данных, либо вовсе не потеряла в точности, либо потеря была незначительной.
В интеллектуальном анализе данных эта задача известна как отбор признаков или отбор переменных (variable selection, feature selection), а также снижение размерности пространства признаков (dimensionality reduction) и относится к этапу предобработки данных. Решение этой задачи позволяет не только сделать модель проще, а результаты работы — понятнее, но и уменьшить вычислительные затраты при ее построении и практическом использовании.
В настоящее время в аналитических технологиях используется множество методов сокращения размерности, наиболее популярными из которых являются последовательное (прямое и обратное) включение и исключение переменных. Кроме того, широко используется корреляционный анализ, который исключает входные переменные, сильно коррелирующие между собой или слабо — с выходной переменной
Кроме отбора, для сокращения размерности используется метод извлечения признаков (feature extraction). Он отличается тем, что не выбирает их из множества уже заданных, а формирует новые, как на основе существующих, так и создавая структуру признаков «с нуля» из неструктурированных данных.
Все перечисленные подходы имеют недостатки, снижающие эффективность их практического использования. Например, если обнаружено наличие корреляции между двумя входными переменными, то возникает вопрос: какую из них следует исключить? При исключении переменных, слабо коррелированных с выходной, проблемой является выбор адекватного порога коэффициента корреляции.
Еще одной проблемой предсказательного моделирования является наличие скрытых (латентных) переменных, о существовании которых может быть вообще неизвестно, и их значения нельзя (или очень сложно) измерить. Они проявляют себя только за счет влияния на известные, явно заданные переменные. Такую гипотетическую, ненаблюдаемую явно величину, «объясняющую» поведение наблюдаемых величин, называют фактором.
Поскольку факторы способны описывать поведение известных, наблюдаемых переменных, их вычисление и дальнейшая интерпретация могут представлять значительный интерес с точки зрения анализа. Методология восстановления факторов на основе большого числа наблюдений получила название факторный анализ (ФА). Число выделяемых факторов должно быть меньше числа исходных переменных, а их структура и взаимосвязи — как можно более простыми (факторы должны быть некоррелированными).
Исходной предпосылкой ФА является наличие сильной статистической связи между несколькими одновременно наблюдаемыми переменными. Количественной мерой такой связи является коэффициент корреляции, который может принимать значения −1 до +1. Если он близок к нулю, это свидетельствует о слабой линейной зависимости, но чем он ближе к ±1, тем более сильная линейная связь существует между переменными. Следует отметить, что ФА не гарантирует получения осмысленных и практически полезных результатов, поскольку корреляция не отражает причинно-следственные и нелинейные зависимости. Поэтому необходима содержательная интерпретация факторов.
ФА особенно полезен в исследованиях, где существуют величины, которые сложно напрямую измерить или учесть. Такие скрытые характеристики нельзя наблюдать непосредственно, но их можно выявить и описать с помощью анализа данных. Поэтому неслучайно, что ФА первоначально появился в психологии как математический метод изучения интеллекта. В середине XX века он получил более широкое применение и стал использоваться как общенаучный метод. Сегодня факторный анализ является важным инструментом многих статистических методов и аналитических платформ.
Основная идея ФА была сформулирована Ф. Гальтоном, основоположником измерений индивидуальных различий: если несколько признаков, измеренных на группе наблюдений, изменяются согласованно, то можно предположить существование общей причины этой совместной изменчивости — скрытого (латентного) фактора, непосредственно недоступного для измерения.
В 1901 году К. Пирсон выдвинул идею «метода главных осей», а Ч. Спирмен разработал математический аппарат для однофакторной оценки. В своей работе, опубликованной в 1904 году, он показал, что если ряд признаков попарно коррелируют друг с другом, то может быть составлена система линейных уравнений, связывающая их в один общий фактор.
В 1930-х годах Л. Терстоун предложил переход к многофакторному анализу для описания множества переменных меньшим числом общих факторов, представляющих собой их линейные комбинации. С 1950-х годов, с появлением компьютеров, ФА начинает очень широко использоваться в психологии при разработке тестов, обосновании структурных теорий интеллекта и личности.
При этом исследователь начинает с набора измеренных эмпирических показателей, которые при помощи ФА группируются по факторам (изучаемым свойствам). Факторы интерпретируются на основе входящих в них переменных, затем отбираются наиболее «значимые» показатели этих факторов, отсеиваются малозначимые, вычисляются значения факторов для испытуемых и сопоставляются с внешними показателями изучаемых свойств.
По мере развития математического аппарата и накопления опыта использования ФА его задача обобщается, и как общенаучный метод он становится инструментом для замены набора коррелирующих переменных существенно меньшим числом новых переменных (факторов). При этом должны выполняться требования:
Из сказанного выше можно сделать вывод, что главная цель ФА — уменьшение размерности исходных данных с целью их компактного описания при условии минимальных потерь исходной информации. Результатом ФА является переход от множества исходных переменных к существенно меньшему числу новых переменных — факторов.
Фактор при этом интерпретируется как причина совместной изменчивости нескольких исходных переменных. Так, на рисунке ниже схематично показано, что фактор F_{1} объясняет изменчивость переменных X_{1}, X_{3} и X_{5}, а фактор F_{2} — X_{2} и X_{4}.
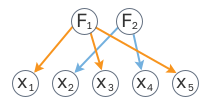
Интерпретация факторов
Если исходить из предположения, что корреляции могут быть обусловлены влиянием скрытых причин, то основное назначение ФА — анализ корреляций множества признаков. Рассмотрим случай, когда заданы две переменные X_{1} и X_{2} и два вектора наблюдений, образующих матрицу:
| № наблюдения | X_{1} | X_{2} |
|---|---|---|
| 1 | X_{11}=4 | X_{12}=1 |
| 2 | X_{21}=8 | X_{22}=5 |
Геометрическая интерпретация таблицы признаков представлена на рисунке ниже.

Геометрическая интерпретация таблицы признаков
Поскольку пространство признаков в приведенном примере двумерное, в нем могут быть вычислены два средних значения и две дисперсии, отражающие изменчивость по каждой из осей X_{1} и X_{2}. Средние будут:
E(X_{1})=\frac{1}{m}\sum\limits_{i=1}^{m}x_{i}=\frac{4+8}{2}=6,
E(X_{2})=\frac{1}{m}\sum\limits_{j=1}^{m}x_{j}=\frac{1+5}{2}=3,
где m — число наблюдений (объем выборки).
Теперь определим дисперсии:
D(X_{1})=\frac{1}{m}\sum\limits_{i=1}^{m}(x_{i}-E(X_{1}))^{2}=\frac{(4-6)^{2}+(8-6)^{2}}{2}=4.
D(X_{2})=\frac{1}{m}\sum\limits_{j=1}^{m}(x_{j}-E(X_{2}))^{2}=\frac{(1-3)^{2}+(5-3)^{2}}{2}=4.
Таким образом, получены частные дисперсии по каждой переменной. Если бы переменные были полностью независимы, то для определения полной дисперсии системы их частные дисперсии можно было просто просуммировать. Однако на практике переменные обычно зависимы и для характеристики их совместной изменчивости используется статистическая мера, называемая ковариацией (covariation — совместная изменчивость), которая вычисляется по формуле:
cov(X_{1},X_{2})=\frac{1}{m}\sum\limits_{k=1}^{m}((x_{ki}‐E(X_{1}))(x_{kj}‐E(X_{2}))),
где k=1..m — индексы наблюдений (строки), i и j — индексы переменных (столбцов). В данном примере i=1 иj=2.
Несложно увидеть, что ковариация переменной с самой собой, то есть:
cov(X_{1},X_{1})=\frac{1}{m}\sum\limits_{k=1}^{m}[(x_{ki}‐E(X_{1}))(x_{ki}‐E(X_{1}))]=\frac{1}{m}\sum\limits_{k=1}^{m}(x_{ki}‐E(X_{1}))^{2},
равна ее дисперсии. Кроме этого, если переменные независимы, то их ковариация равна 0. При этом обратное утверждение не верно: нулевая ковариация не гарантирует независимость.
Вычислим ковариацию для переменных из нашего примера:
где cov(X_{1},X_{2})=\frac{1}{m}\sum\limits_{k=1}^{m}((x_{ki} − E(X_{1}))(x_{kj} − E(X_{2})))=
=((x_{11}− E(X_{1}))(x_{12}−E(X_{2}))+(x_{21}-E(X_{1}))(x_{22}-E(X_{2})))/2=
=((4-6)(1-3)+(8-6)(5-3))/2=4.
В отличие от частной дисперсии, которая благодаря квадрату принимает только положительные значения, ковариация, хотя и связана с ней, может быть и отрицательной величиной.
Теперь попытаемся сделать то, ради чего и были выполнены эти преобразования. Пусть переменная X_{1} — это доход заемщика, а X_{2}— стоимость его автомобиля. С точки зрения оценки кредитоспособности эти переменные несут фактически одну и ту же информацию о финансовом благополучии клиента. Поэтому, с целью сокращения размерности модели, логично будет попытаться использовать вместо этих двух переменных одну, которая будет их линейной комбинацией и содержать ту же информацию. Такая переменная и называется фактором.
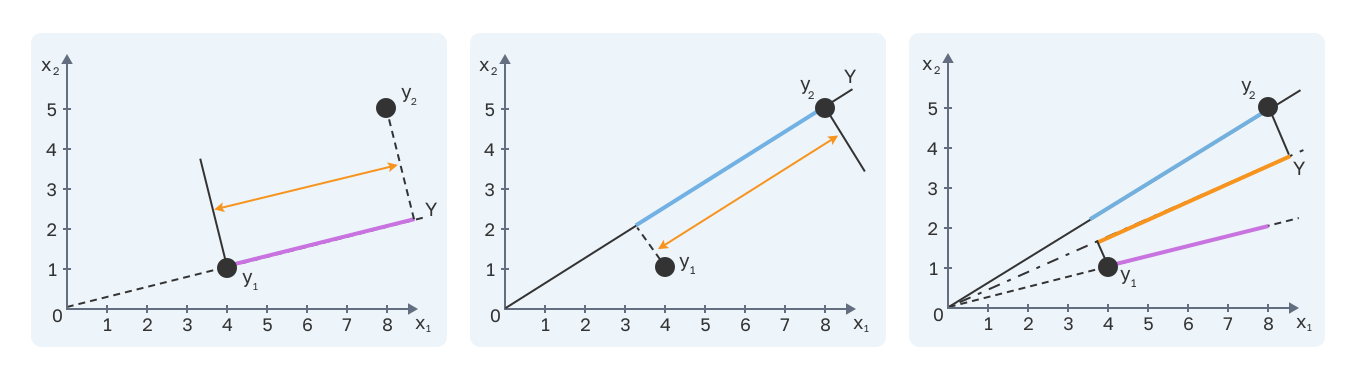
Определение фактора эквивалентно формированию новой оси в пространстве признаков, или факторной оси. Условием того, что факторная переменная будет нести максимально возможную долю информации, ранее выраженную двумя исходными переменными, является то, что дисперсия их значений вдоль этой новой оси будет наибольшей. Рассмотрим графическую интерпретацию сказанного с помощью рисунка.
Факторная ось
Интуитивно понятно, что дисперсия вдоль факторной оси будет тем выше, чем больше расстояние между ортогональными проекциями y_{1} и y_{2} исходных векторов на ось Y. Следовательно, надо расположить факторную ось так, чтобы расстояние \hat{y}_{1}-\hat{y}_{2}, заданное ортогональными проекциями векторов на Y, было максимальным. После этого можно вычислить ковариацию для новой переменной Y, которая, как было отмечено выше, будет совпадать с ее дисперсией:
cov(Y,Y)=\frac{1}{m}\sum\limits_{k=1}^{m}((y_k‐E(Y))(y_{k}‐E(Y))).
Таким образом, с фактором Y связана некоторая изменчивость, выраженная автоковариацией cov(Y,Y) или дисперсией D(Y), а с исходной системой X_{1} и X_{2} — изменчивость, выраженная ковариацией cov(X_{1}, X_{2}). Возникает вопрос, насколько значительна доля изменчивости, унаследованная Y от X_{1} и X_{2} ? Достаточна ли она для того, чтобы информативность Y можно было считать близкой к информативности обеих исходных переменных?
Часть общей дисперсии исходного набора переменных, унаследованная фактором, называется дисперсией, объясненной данным фактором. Если доля объясненной дисперсии велика, например 90%, то можно утверждать, что изменчивость исходных переменных практически полностью описывается (объясняется) этим фактором.
В настоящее время разработано множество методов выделения факторов: метод главных компонент, метод главных осей, канонический метод Рао и другие. Наиболее популярным и входящим в большинство статистических пакетов и аналитических платформ, является метод главных компонент (Principal Component Analysis — PCA). Более того, некоторые авторы склонны сводить факторный анализ только к PCA, что, вообще говоря, не совсем корректно. Часто, работая с опцией «Факторный анализ» статистического или аналитического приложения, пользователь использует именно PCA, хотя напрямую в программном средстве это может не указываться.
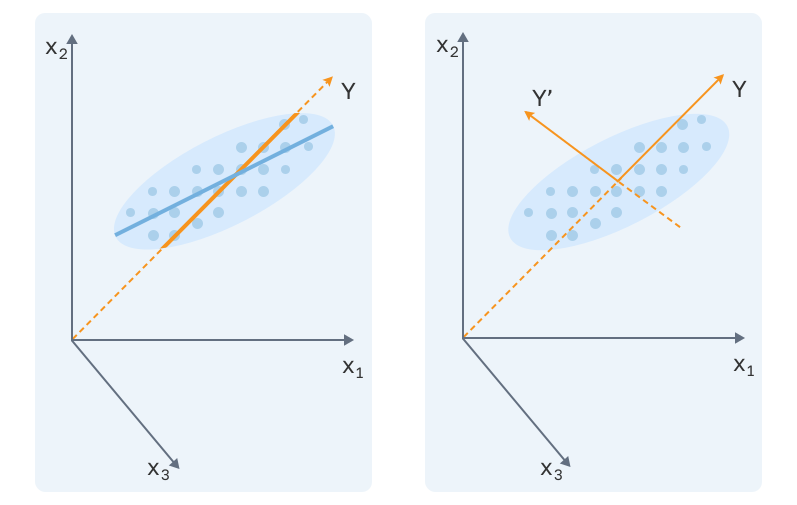
Проинтерпретируем графически корреляцию между двумя переменными для большого числа наблюдений. Если в данных имеется ярко выраженная корреляция между переменными, то «облако» точек, визуализированное в многомерном пространстве, будет представлять собой вытянутый эллипсоид, наклон которого определяется знаком корреляции: при положительной корреляции он направлен вверх, при отрицательной — вниз.
Корреляция в пространстве
Тогда факторная ось Y должна быть построена так, чтобы вдоль нее наблюдалась максимально возможная изменчивость данных. В идеале она должна геометрически совпадать с длинной осью эллипсоида, что обеспечит максимально возможную долю изменчивости вдоль Y.
В методе PCA такие новые переменные называются главными компонентами. Однако на рисунке хорошо видно, что это не так, и ось Y не совпадает с главной осью эллипсоида. Это означает, что часть вариативности исходных переменных оказалась не объясненной (иными словами, осталась значительная доля необъясненной дисперсии).
Логичным выходом является построение еще одной факторной оси (компоненты), которая должна максимально выразить необъясненную дисперсию, но при этом быть независимой от первой. Очевидно, что в идеальном случае вторая компонента должна совпадать с короткой осью эллипсоида. Но здесь есть проблема — компоненты должны быть независимы (некоррелированы) и, следовательно, ортогональны, т.е. располагаться под углом 90 градусов.
Понятно, что в этом случае совпадение короткой оси эллипса и второй компоненты также не гарантируется и вновь останется необъясненная дисперсия, для которой можно будет построить еще одну компоненту, ортогональную ранее построенным. При этом наибольшая доля объясненной дисперсии будет связана с первой компонентой и будет уменьшаться для каждой последующей. А для компонент с большими порядковыми номерами она окажется совсем малой, что позволяет исключить их из рассмотрения без значительного снижения информативности. На этом и основан принцип снижения размерности метода PCA.
Процедура построения факторных осей повторяется итеративно до тех пор, пока совокупная доля объясненной дисперсии не будет составлять заданный процент от исходной или пока не будет сформировано заданное число компонент. Затем производится выбор числа компонент для использования в дальнейшем анализе и их интерпретация.
Сделанный выше обзор позволяет понять базовые принципы PCA, но недостаточен для того, чтобы правильно выбрать его параметры (число компонент, долю дисперсии), а также правильно интерпретировать результаты. Поэтому далее будут рассмотрены некоторые математические аспекты PCA, которые позволят корректно использовать метод на практике.
Таким образом, метод главных компонент используется для описания корреляционной структуры набора переменных с помощью их линейных комбинаций, называемых компонентами. Вычисление главных компонент является достаточно трудоемкой процедурой, требующей математических знаний — матричной алгебры и математической статистики. Поэтому мы попытаемся рассмотреть реализацию PCA на простейшем бизнес-примере.
Пусть туристическое агентство реализует программу маркетинговых исследований, которая включает опрос клиентов с целью оценки значимости условий отдыха, влияющих на выбор тура. В качестве таких условий были выбраны:
Клиенту предлагалось оценить значимость каждого условия, приписав ему некоторый балл. Затем баллы подвергались исследованию для выявления причин, побуждающих клиентов к покупке того или иного тура. Результаты опроса представлены в таблице.
| ID клиента | Стоимость путевки | Уровень комфорта | Температура воздуха | Температура воды |
|---|---|---|---|---|
| K1 | 32 | 64 | 65 | 67 |
| K2 | 61 | 37 | 62 | 65 |
| K3 | 40 | 45 | 43 | |
| K4 | 36 | 62 | 34 | 35 |
| K5 | 62 | 46 | 43 | 40 |
Вычислим для этих данных корреляционную матрицу c использованием коэффициента корреляции Пирсона (значения округлены):
| Переменная | Стоимость путевки | Уровень комфорта | Температура воздуха | Температура воды |
|---|---|---|---|---|
| Стоимость путевки | 1.000 | -0.953 | -0.055 | -0.130 |
| Уровень комфорта | -0.953 | 1.000 | -0.091 | -0.036 |
| Температура воздуха | -0.055 | -0.091 | 1.000 | 0.990 |
| Температура воды | -0.130 | -0.036 | 0.990 | 1.000 |
Наибольшая корреляция наблюдается между температурой воздуха и температурой воды (0.990), что вполне ожидаемо. Также высокая (по модулю) корреляция имеет место между стоимостью путевки и уровнем комфорта, что тоже логично. В то же время ни стоимость тура, ни уровень комфорта с температурой воздуха и температурой воды практически не коррелированы. Таким образом, наличие корреляционных связей между переменными легко установить даже визуально.
Из матричной алгебры известно, что матрицы, удовлетворяющие определенным условиям, могут быть диагонализованы, т.е. преобразованы к виду, когда по главной диагонали есть некоторые значения, а все остальные элементы равны нулю. Для этого используется следующее преобразование:
\textbf{L}=\textbf{V}^{T}\textbf{RV}, (1)
т.е. диагонализация матрицы \textbf{R} производится путем ее умножения слева сначала на транспонированную матрицу \textbf{V}^{T}, а затем справа на саму матрицу преобразования \textbf{V}, столбцы которой называются собственными векторами, а элементы на ее главной диагонали — собственными значениями.
Пусть \textbf{B} — матрица размером m\times m элементов, \textbf{I} — единичная матрица m\times m, в которой все значения главной диагонали равны 1, а остальные нулю. Тогда скалярные величины \lambda_{1},\lambda_{2},...,\lambda_{m} называются собственными значениями матрицы \textbf{B}, если \left| \textbf{B}-\lambda\textbf{I} \right|=0
Ненулевой вектор \textbf{e} размером m\times 1 называется ее собственным вектором \textbf{B}, если \textbf{Be}=\lambda\textbf{e}.
Поскольку в нашем примере четыре переменных, в результате преобразования мы получим 4 собственных вектора и 4 собственных значения. Но поскольку целью ФА является представление корреляционной матрицы R с помощью минимально возможного числа факторов, обычно рассматриваются только факторы с большими собственными значениями.
В нашем примере собственные значения будут равны \lambda_{1}=2.02, \lambda_{2}=1.94, \lambda_{3}=0.04 и \lambda_{4}=0.00 и вычисляются для каждого из 4-х возможных факторов. Только для первых двух из них собственные значения достаточно велики, чтобы стать предметом дальнейшего рассмотрения. Поэтому для дальнейшего анализа оставляем только первые две компоненты с собственными значениями 2.02 и 1.94 (округленные). Используя уравнение (1) и подставляя значения из приведенного примера, получаем:
\textbf{L}=\begin{bmatrix} -0.283 & 0.177 & 0.658 & 0.675 \\ 0.651 & -0.685 & 0.252 & 0.207 \end{bmatrix}\begin{bmatrix} 1.000 & -0.953 & -0.055 & -0.130 \\ -0.953 & 1.000 & -0.091 & -0.036 \\ -0.055 & -0.091 & 1.000 & 0.990 \\ -0.130 & -0.036 & 0.990 & 1.000 \end{bmatrix}\begin{bmatrix} -0.283 & 0.651 \\ 0.177 & -0.685 \\ 0.658 & 0.252 \\ 0.675 & 0.207 \end{bmatrix}==\begin{bmatrix} 2.02 & 0.00 \\ 0.00 & 1.94 \end{bmatrix}
Умножение слева матрицы собственных векторов на транспонированную к ней дает единичную матрицу \textbf{E} (с единицами на главной диагонали и остальными нулями). Поэтому можно сказать, что преобразование матрицы корреляций по формуле (1) не приводит к потере информации, а лишь преобразует матрицу к более удобному для анализа виду \textbf{V}^{T}\textbf{V}=\textbf{E}.
\begin{bmatrix} -0.283 & 0.177 & 0.658 & 0.675 \\ 0.651 & -0.685 & 0.252 & 0.207 \end{bmatrix}\begin{bmatrix} -0.283 & 0.651 \\ 0.177 & -0.685 \\ 0.658 & 0.252 \\ 0.675 & 0.207 \end{bmatrix}=\begin{bmatrix} 1.00 & 0.00 \\ 0.00 & 1.00 \end{bmatrix}
Собственные значения и собственные векторы для рассмотренного примера представлены в таблице:
| Собственные векторы | Собственные значения | ||||
|---|---|---|---|---|---|
| Собственный вектор 1 | -0.283 | 0.177 | 0.658 | 0.675 | 2.020 |
| Собственный вектор 2 | 0.651 | -0.685 | 0.252 | 0.207 | 1.940 |
Если корреляционная матрица диагонализируема, то вся существенная информация о факторной структуре содержится в ее диагональной форме. В ФА собственные числа соответствуют дисперсии, объясняемой факторами. Фактор с наибольшим собственным значением объясняет наибольшую дисперсию и т.д., пока не доходит до факторов с небольшими или отрицательными собственными значениями, которые обычно не учитываются при анализе.
Расчеты собственных значений и собственных векторов трудоемки, и умение их вычислять не является крайней необходимостью для аналитика, осваивающего ФА в практических целях.
После нахождения собственных чисел и собственных векторов корреляционной матрицы, оставшаяся часть PCA достаточно прозрачна. Исходя из их определения, корреляционную матрицу можно представить в виде произведения трех матриц: матрицы собственных значений, матрицы собственных векторов и транспонированной к ней, т.е.
\textbf{R}=\textbf{VLV}^{T}.
Можно записать: \textbf{L}=\sqrt{\textbf{L}}\sqrt{\textbf{L}}, тогда \textbf{R}=\textbf{V}\sqrt{\textbf{L}}\sqrt{\textbf{L}}\textbf{V}^{T}. Если обозначить \textbf{V}\sqrt{\textbf{L}}=\textbf{A}, а \sqrt{\textbf{L}}\textbf{V}^{T}=\textbf{A}^{T}, то получим:
\textbf{R}=\textbf{AA}^{T}.
Это означает, что корреляционная матрица может быть представлена как произведение двух матриц, каждая из которых является линейной комбинацией ее собственных векторов и значений. Последнее выражение называют основным уравнением факторного анализа. Оно показывает, что корреляционная матрица может быть представлена с помощью матрицы факторных нагрузок и матрицы, транспонированной к ней.
Таким образом, большая часть вычислений, связанных с PCA, заключается в поиске собственных векторов и собственных значений, и как только они будут найдены, факторная матрица получится на основе матричного умножения \textbf{A}=\textbf{V}\sqrt{\textbf{L}}. Для нашего примера будет:
\begin{bmatrix} -0.283 & 0.651 \\ 0.177 & -0.685 \\ 0.658 & 0.252 \\ 0.675 & 0.207 \end{bmatrix}\begin{bmatrix} \sqrt{2.02} & 0.00 \\ 0.00 & \sqrt{1.94} \end{bmatrix}\begin{bmatrix} -0.400 & 0.900 \\ 0.251 & -0.947 \\ 0.932 & 0.348 \\ 0.956 & 0.286 \end{bmatrix} .
Матрица нагрузок представляет собой матрицу корреляций между компонентами и исходными переменными. Первый столбец — это корреляции между каждым фактором и каждой переменной по очереди.
| Переменная | Фактор 1 | Фактор 2 |
|---|---|---|
| Стоимость тура | -0.400 | 0.900 |
| Уровень комфорта | 0.251 | -0.947 |
| Температура воздуха | 0.932 | 0.348 |
| Температура воды | 0.956 | 0.286 |
Факторы интерпретируются на основе того, с какими переменными у них наибольшая корреляция. Так, фактор 1 является «климатическим», поскольку имеет высокую корреляцию с температурой воздуха и воды. А второй фактор можно назвать «экономическим» — стоимость тура и уровень комфорта.
Обратите внимание, что переменные, имеющие высокие нагрузки по первому фактору, связаны положительно, что очевидно: чем выше температура воздуха, тем выше температура воды. В то же время нагрузки переменных по второму фактору имеют различный знак: от дешевых туров нельзя ожидать высокого комфорта. Первый фактор является униполярным (все переменные сгруппированы на одном полюсе), а второй — биполярным (переменные распались на две противоположные по смыслу группы — два полюса).
Переменные, имеющие нагрузки больше 0, образуют «положительный» полюс, а меньше 0 — «отрицательный». При этом названия полюсов «положительный» и «отрицательный» при интерпретации фактора не имеют оценочного смысла, типа «плохой» и «хороший».
В примере переменная «Стоимость тура» оказалась на «положительном» полюсе, ей противопоставлена переменная «Уровень комфорта» на «отрицательном». И это можно проинтерпретировать как противопоставление экономичности комфорту. Респонденты, для которых проблема экономии существенна, оказались на одном «полюсе» — получили факторные значения со знаком «+».
При выборе тура они более ориентируются на его низкую стоимость и менее — на уровень комфорта. Респонденты, не экономящие на отдыхе (цена путевки их не интересует) и желающие отдохнуть прежде всего в комфортных условиях, оказались на другом «полюсе» — получили факторные нагрузки со знаком «-».
В этом простом примере интерпретация очевидна, но в случае реальных данных не все так просто. Обычно фактор легче интерпретируется, если с ним взаимосвязана только небольшая часть переменных.
Пусть изначально набор данных содержит m переменных. Как отмечено выше, с помощью ФА их общая изменчивость (дисперсия) может быть описана линейной комбинацией меньшего числа компонент таким образом, что почти вся информация, которая содержится во всех m переменных, содержалась бы также и в k компонентах.
Следовательно, при построении аналитической модели можно заменить m переменных на k компонент (факторов). В результате набор данных будет содержать n наблюдений по k компонентам, а не по m переменным.
Предположим, что переменные X_{1},X_{2},...,X_{m} образуют систему координат в m-мерном пространстве. Компоненты формируют новую координатную систему путем создания осей по направлениям, вдоль которых дисперсия значений максимальна. При подготовке к выполнению процедуры выделения компонент необходимо произвести стандартизацию данных так, чтобы среднее каждой переменной равнялось нулю, а стандартное отклонение — единице. Стандартизация необходима для приведения разнородных данных к единой шкале.
Пусть каждая переменная X представляется n-элементным вектором x_{1},x_{2},...,x_{n}, где n — число наблюдений в наборе данных. Тогда стандартизированная переменная также представляется как n-компонентный вектор \textbf{Z}_{i}=(x_{i}-\mu_{i})/\sigma_{ii}, где \mu_{i} и \sigma_{ii} — среднее значение и стандартное отклонение. В матричном виде операция стандартизации записывается как:
\textbf{Z}=(\textbf{S})^{T}(\textbf{X}-\mu),
где \textbf{S} — диагональная матрица стандартных отклонений размером m\times m:
\begin{bmatrix} \sigma_{11} & 0 & ... & 0 \\ 0& \sigma_{22} & ... & 0 \\ \vdots & \vdots & \ddots & \vdots \\ 0 & 0 & ... & \sigma_{mm} \end{bmatrix}
Диагональная матрица совпадает со своей транспонированной версией, поскольку транспонирование не влияет на расположение элементов, потому что все ненулевые элементы находятся на главной диагонали, а относительно неё матрица уже симметрична. Следовательно операцию транспонирования можно опустить.
Обозначим \Sigma симметричную ковариационную матрицу вида
\Sigma=\begin{bmatrix} \sigma^{2}_{11} & \sigma^{2}_{12} & \cdots & \sigma^{2}_{1m} \\ \sigma^{2}_{21} & \sigma^{2}_{22} & \cdots & \sigma^{2}_{2m} \\ \vdots & \vdots & \ddots & \vdots \\ \sigma^{2}_{m1} & \sigma^{2}_{m2} & \cdots & \sigma^{2}_{mm} \end{bmatrix}
где \sigma^{2}_{ij}(i\neq j) — ковариация между переменными X_{i} и X_{j}, вычисляемая по формуле:
\sigma^{2}_{ij}=\frac{1}{m}\sum\limits_{t=1}^{n}(x_{ti}-\mu_{i})(x_{tj}-\mu_{j}),
где t=1..n — номер наблюдения в наборе данных.
Если ввести коэффициент корреляции как:
r_{ij}=\frac{\sigma_{ij}}{\sigma_{ii}\sigma_{jj}},
то корреляционную матрицу \textbf{R} можно представить в виде:
\textbf{R}=\begin{bmatrix} \frac{\sigma_{11}^{2}}{\sigma_{11}\sigma_{11}} & \frac{\sigma_{12}^{2}}{\sigma_{11}\sigma_{22}} & \cdots & \frac{\sigma_{1m}^{2}}{\sigma_{11}\sigma_{mm}} \\ \frac{\sigma_{21}^{2}}{\sigma_{22}\sigma_{11}} & \frac{\sigma_{22}^{2}}{\sigma_{22}\sigma_{22}} & \cdots & \frac{\sigma_{2m}^{2}}{\sigma_{22}\sigma_{mm}} \\ \cdots & \cdots & \ddots & \cdots \\ \frac{\sigma_{m1}^{2}}{\sigma_{mm}\sigma_{11}} & \frac{\sigma_{m2}^{2}}{\sigma_{mm}\sigma_{22}} & \cdots & \frac{\sigma_{mm}^{2}}{\sigma_{mm}\sigma_{mm}} \end{bmatrix}.
Вновь рассмотрим стандартизированную матрицу \textbf{Z}=(\textbf{S})^{T}(\textbf{X}-\mu). Поскольку каждая переменная стандартизирована, E(\textbf{Z})=\textbf{O}, где \textbf{O} — n-элементный вектор, состоящий из нулей, а \textbf{Z} имеет ковариационную матрицу
Cov(\textbf{Z})=(\textbf{S})^{-1}\Sigma(\textbf{S})^{-1}=\textbf{R}.
Следовательно, для стандартизированного набора данных ковариационная и корреляционная матрицы совпадают и для описания взаимной вариативности стандартизированных переменных достаточно использовать корреляционную матрицу.
Тогда i-й главной компонентой стандартизированной матрицы \textbf{Z}=[Z_{1},Z_{2},...,Z_{m}] является вектор \textbf{Y}_{i}=\textbf{e}^{T}_{i}\textbf{Z}\textbf{e}_{i}, в котором \textbf{e}_{i} — i-й собственный вектор, а \textbf{e}_{i}^{T} — его транспонированный вариант.
Таким образом, i-я главная компонента будет являться линейной комбинацией:
Y_{i}=\textbf{e}^{T}_{i}\textbf{Z}=e_{11}Z_{1}+e_{12}Z_{2}+...+e_{1m}Z_{m},
которая имеет дисперсию большую, чем любая другая возможная линейная комбинация переменных \textbf{Z}. Следовательно:
Таким образом, ФА можно рассматривать как метод декомпозиции ковариационной или корреляционной матрицы на ортогональные векторы по числу рассматриваемых переменных, которые соответствуют собственным векторам и собственным значениям корреляционных матриц. Собственные значения обычно упорядочиваются по убыванию величины. Векторы попарно ортогональны, и полученные по ним компоненты некоррелированы. Хотя несколько компонент могут выразить (объяснить) большую часть дисперсии (изменчивости) исходного набора переменных, для выражения его полной дисперсии требуются все компоненты.
Приведем еще три важных замечания, способствующих лучшему пониманию принципов PCA:
В основе ФА лежит гипотеза, что информацию, содержащуюся в исходном наборе переменных, можно выразить меньшим числом факторов. Если данную гипотезу удастся подтвердить, применимость факторного анализа будет подтверждена. Рассмотрим, как это делается на абстрактных данных.
Пусть задана корреляционная матрица для 4-х переменных:
\textbf{R}=\begin{bmatrix} r_{11} & r_{12} & r_{13} & r_{14} \\ r_{21} & r_{22} & r_{23} & r_{24} \\ r_{31} & r_{32} & r_{33} & r_{34} \\ r_{41} & r_{42} & r_{43} & r_{44} \end{bmatrix}=\begin{bmatrix} 1.000 & 0.720 & 0.450 & 0.045 \\ 0.720 & 1.000 & 0.400 & 0.040 \\ 0.450 & 0.400 & 1.000 & 0.025 \\ 0.045 & 0.040 & 0.025 & 1.000 \end{bmatrix}.
Наибольшая связь наблюдается между 1-й и 2-й переменными (r_{12}=r_{21}=0.72), между 1-й и 3-й (r_{13}=r_{31}=0.45), а также между 2-й и 3-й (r_{23}=r_{32}=0.40). Связи 4-й переменной с остальными пренебрежимо малы.
Коэффициенты корреляционной матрицы можно воспроизвести следующим образом:
\begin{bmatrix} (0.810) & 0.720 & 0.450 & 0.045 \\ 0.720 & (0.640) & 0.400 & 0.040 \\ 0.450 & 0.400 & (0.250) & 0.025 \\ 0.045 & 0.040 & 0.025 & (0.0025) \end{bmatrix}=\begin{bmatrix} 0.90 \\ 0.80 \\ 0.50 \\ 0.05 \end{bmatrix}\begin{bmatrix} 0.90 & 0.80 & 0.50 & 0.05 \end{bmatrix}(2)
или в матричном виде \textbf{R}^{+}=\textbf{A}_{1}\textbf{A}^{T}_{1}, где \textbf{A}^{T}_{1} — это фактор, а \textbf{R}^{+} — матрица воспроизведенных коэффициентов корреляции. Единственное отличие от исходной матрицы \textbf{R} в диагональных элементах, называемых общностями. Значения вектора \textbf{A}_{1} называют факторными нагрузками, с помощью которых можно «объяснить» все элементы корреляционной матрицы, кроме диагональных. Иными словами, за коэффициентами корреляции стоит фактор, который причинно обусловливает их.
Уравнение (2) является развернутым аналогом основного уравнения ФА (1). Наблюдаемые корреляции рассматриваются как проявление скрытой величины (фактора), на основе которой они могут быть вычислен. Фактор представляет собой скрытую переменную, объясняющую общую изменчивость наблюдаемых величин. Он гипотетичен, но должен иметь такую конструкцию, чтобы с его помощью можно было получить наблюдаемые корреляции. ФА и определяет такие гипотетические факторы.
Если приводить корреляционную матрицу \textbf{R} к форме (1), возникают две проблемы. Диагональные элементы матрицы \textbf{R}^{+} меньше единицы, поэтому прежде чем вычислить искомую правую часть, нужно установить заключенные в скобки диагональные элементы в левой части — общности. Оценка общностей составляет первую задачу факторного анализа. Второй задачей является определение самого фактора.
Таким образом, все значения корреляционной матрицы оказываются выраженными через четыре значения вектора \textbf{A}_{1}, который содержит большую часть информации о связи исходных переменных с факторами, содержащуюся во всей корреляционной матрице. Следовательно, вектор факторных нагрузок определяет более простую модель с минимальной потерей информации относительно исходного набора переменных.
Итак, в первой части данной статье мы рассмотрели цели, задачи и математический аппарат факторного анализа, а также то, как интерпретировать и применять его результаты на практике. Однако это не все проблемы, связанные с его использованием. За рамками рассмотрения остались такие важные вопросы, как выбор и оптимизация структуры выделенных факторов с помощью вращения факторных осей, а также задача выбора числа используемых для анализа факторов. Эти вопросы будут рассмотрены во второй части статьи — «Вращение факторов и интерпретация результатов».
Другие материалы по теме: