Данные можно извлекать и обрабатывать множеством способов: использовать SQL, писать код, применять AI. Но чем больше источников и аналитических задач у компании, тем важнее становится не отдельный инструмент, а организованный процесс работы с данными.
ETL — один из основных способов интеграции данных из различных информационных систем. Его используют при построении хранилищ данных (Data Warehouse), корпоративной отчетности, BI-систем и аналитических платформ.
Пока источников немного, данные можно собирать и обрабатывать вручную или отдельными скриптами. Но по мере роста компании увеличивается объем данных, количество информационных систем и число задач, для которых они используются. Возникает необходимость выстроить корпоративный ETL-процесс.
В статье рассматриваются пять причин, почему ETL-процесс становится основой корпоративной аналитики.
В крупном бизнесе принятие решений невозможно без объединения различных данных. Информация о клиентах, продажах, заказах и платежах может находиться в CRM, ERP и других учетных системах. Дополнительно компания может использовать внешние источники: сведения о контрагентах, рыночные показатели, рекламную статистику, публикации в СМИ и т.д.
Каждая система хранит данные по своим правилам. Один и тот же клиент может иметь разные идентификаторы, даты могут храниться в разных форматах, а одинаковые показатели — называться по-разному.
Чем больше источников, тем сложнее обеспечивать качество данных. Без единого процесса обработки собрать эти сведения и получить достоверную картину практически невозможно.
Проблема корпоративной аналитики не в дефиците данных, а в необходимости получить из них единую и согласованную картину.
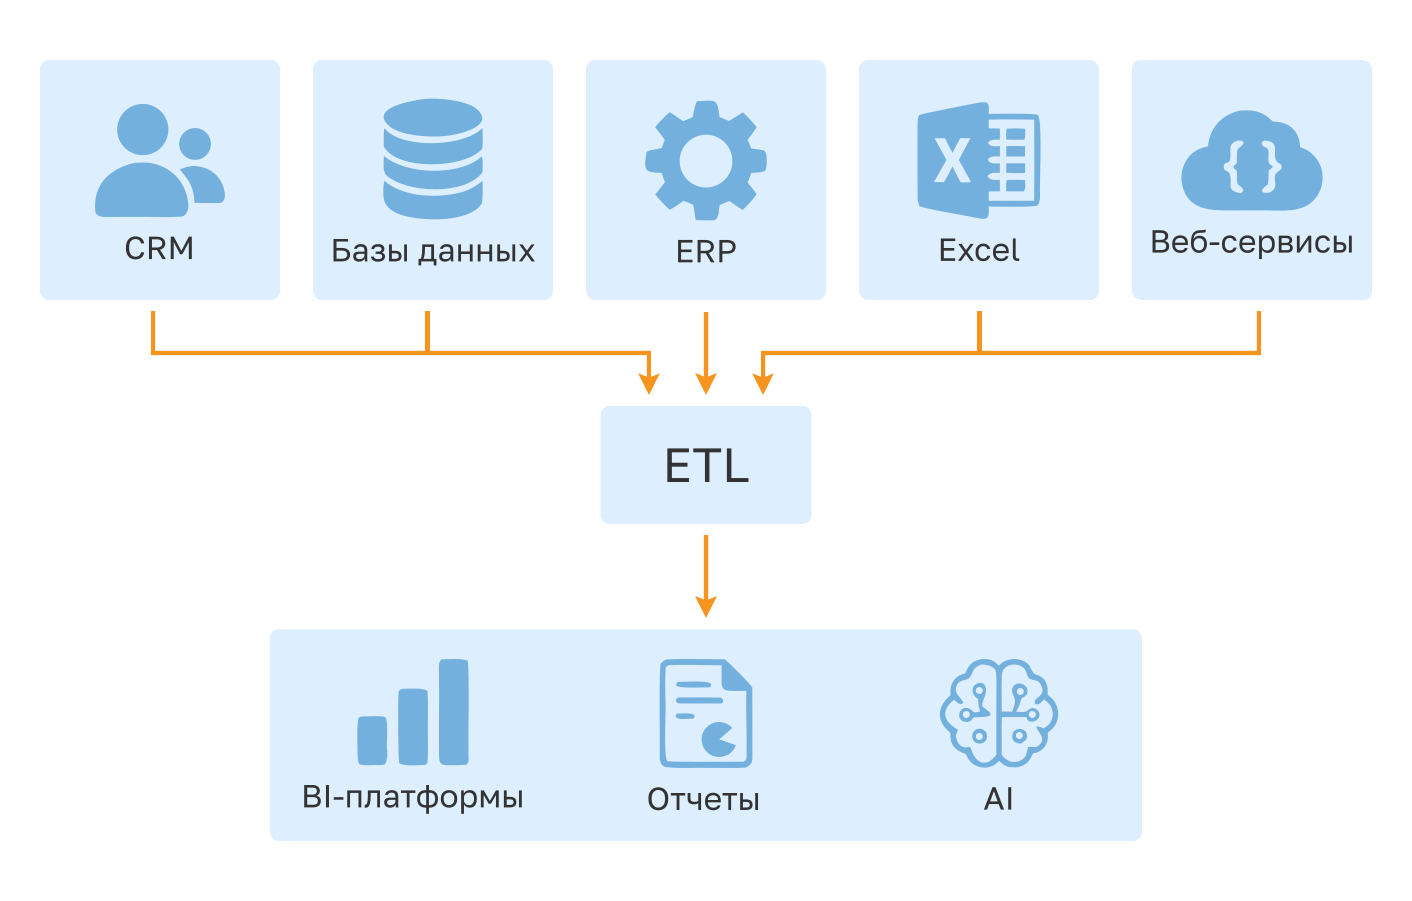
ETL-процесс
Отсутствие систематизированного ETL-процесса при работе с множеством разнородных источников приводит к целому ряду проблем:
Поэтому интеграция — это не просто перенос данных из одной системы в другую. Задача ETL — создать воспроизводимый процесс, который объединяет данные из разных источников и подготавливает их к дальнейшей обработке.
После извлечения данные могут содержать дубликаты, пропуски и другие ошибки. Файлы могут иметь различные форматы и структуру. Поэтому следующий этап ETL — приведение исходных данных к виду, пригодному для дальнейшего анализа. Здесь можно выделить три критически важных направления трансформации: очистку и стандартизацию данных, установление связей между сущностями и сокращение объема данных за счет выделения наиболее значимой информации.
Очистка необходима для устранения дубликатов, пропусков и некорректных значений. Однако подготовка данных не сводится только к устранению ошибок. Не менее важно обеспечить согласованность данных из разных источников: привести их к единому формату и единым правилам представления.
Например, одна и та же дата в разных источниках может быть записана как 14.09.2026, 2026-09-14 или 09/14/2026. Если не привести значения к единому стандарту, результаты расчетов окажутся неверными и будут влиять на весь дальнейший анализ.
Даже если данные полностью очищены, это не гарантирует корректность анализа, если записи из разных источников невозможно правильно сопоставить между собой.
К примеру, один и тот же клиент может быть зарегистрирован в CRM, программе лояльности, ERP-системе и интернет-магазине под различными идентификаторами. Для одной системы это может быть номер клиента, для другой — адрес электронной почты, номер договора или внутренний код.
ETL позволяет сопоставить такие записи и определить, что они относятся к одному объекту. Это позволяет объединить сведения из разных систем и получить целостное представление о клиенте, товаре, заказе или другом объекте бизнеса, несмотря на различия в способах его идентификации.
Исходные массивы данных могут быть очень большими: например, логи веб-сайтов, история транзакций или события в информационных системах. При этом только часть информации нужна для решения аналитической задачи. На этом этапе важно выделить данные, которые нужны для решения задачи, и уменьшить объем информации без потери значимых для анализа сведений.
Этот процесс можно условно сравнить с аудиосжатием: при переходе к формату MP3 часть исходной информации отбрасывается, чтобы уменьшить размер файла, при этом сохраняется информация, необходимая для его воспроизведения и восприятия. В ETL похожий принцип: объем данных может сокращаться за счет фильтрации, агрегации и отбора необходимых полей и записей. Например, вместо хранения каждой отдельной транзакции можно сохранить итоговые показатели продаж по товару, магазину и менеджеру. При этом сохраняется информация, необходимая для конкретных аналитических задач.
ETL делает из огромного массива данных концентрат знаний.
На этих этапах сырые, разрозненные и объемные данные превращаются в структурированный, проверяемый и компактный ресурс, пригодный для анализа и принятия решений.
В процессе трансформации данных необходимо учитывать правила, которые определяют, что и как должно обрабатываться в соответствии с задачами компании. Один и тот же набор операций может иметь разный смысл в зависимости от условий.
Например, в интернет-магазине все заказы хранятся в одной системе, но для разных задач используются разные правила их обработки. Для отчета по продажам необходимо учитывать оплаченные заказы, а для оценки работы менеджеров — заказы, оформленные конкретными сотрудниками. Для расчета среднего чека используется сумма заказа, а для анализа ассортимента — количество проданных товаров. Таким образом, одни и те же исходные данные могут обрабатываться по разным правилам в зависимости от задачи.
Подобные правила относятся не к формату данных, а к логике бизнеса. Они определяют, какие записи учитывать, как классифицировать операции, какие показатели рассчитывать и как интерпретировать полученный результат. Основанием для таких правил могут быть, например, внутренние правила продаж, законодательные требования и корпоративные регламенты.
Без соблюдения этих правил результаты анализа становятся ненадежными. ETL позволяет формализовать требования и закрепить их в процессе обработки данных. При изменении требований достаточно изменить соответствующую логику процесса, а не исправлять вручную множество отчетов.
ETL превращает бизнес-правила из договоренностей между сотрудниками в воспроизводимые правила обработки данных.
Поэтому ETL-процесс должен обеспечивать не только математические операции, но и применение бизнес-правил, которые определяют порядок обработки данных в зависимости от конкретной задачи. При необходимости в процесс также можно включить требования регуляторов, предусмотренные для определенной сферы деятельности компании. Это позволяет получать согласованные и воспроизводимые результаты при каждом цикле обработки данных.
Появление генеративного AI и внедрение LLM в аналитические системы не отменяют важности подготовки данных. Напротив, данные становятся фундаментом для работы как BI, так и AI-инструментов. Чем полнее, точнее и согласованнее исходные данные, тем надежнее результаты аналитики и выводы, которые формируются на их основе.
AI-инструменты способны анализировать большие объемы информации, формировать отчеты и помогать специалистам быстрее решать аналитические задачи. Однако AI может воспринимать несогласованные данные по-разному и самостоятельно устанавливать связи между ними. Если исходные данные содержат противоречия или не имеют четких правил обработки, становится сложнее определить, на чем основан полученный результат и можно ли ему доверять.
AI — помощник инженера, а не замена управляемому ETL-процессу.
Поэтому AI не исключает необходимость профессиональной проверки. Проверка архитектурных решений, тестирование и верификация результатов, а также принятие кода в эксплуатацию остаются областью ответственности специалиста.
Перед передачей данных в BI- и AI-системы необходимо обеспечить их очистку, согласованность и соответствие бизнес-правилам. ETL позволяет формализовать этот процесс и создать единый фундамент для дальнейшего анализа:
Источники данных → ETL → Подготовленные данные → AI и бизнес-аналитика → Результат.
Такой подход позволяет получить преимущества генеративного AI — ускорение разработки и снижение трудозатрат — без потери качества, безопасности и доверия к данным. Именно сочетание возможностей AI и профессиональной экспертизы инженера обеспечивает надежность интеграционных решений для ETL в промышленной эксплуатации.
Доверие к данным — одно из важных условий работы компании. Без него даже самая сложная аналитическая система не приносит ожидаемой пользы. Если руководители сомневаются в цифрах, они начинают перенаправлять усилия отделов на проверки, принимать решения на основе своего опыта, а не данных. И тогда все затраты на сбор, хранение и обработку данных могут оказаться напрасными. Информация есть, аналитические инструменты есть, но использовать их для принятия решений бизнес не готов.
В этом смысле доверие к данным отчасти похоже на доверие между людьми. Его нельзя обеспечить формальной процедурой или приказом. Оно формируется постепенно, когда человек снова и снова получает результат, который соответствует действительности, объясним и понятен.
Если данные невозможно проверить, воспроизвести процесс их получения или понять, как был рассчитан тот или иной показатель, аналитика теряет ценность. В такой ситуации разные подразделения получают разные цифры, отчеты начинают противоречить друг другу, а руководители тратят время на поиск ошибок вместо принятия решений.
Доверие к данным начинается с объяснимого, воспроизводимого и понятного процесса их подготовки.
ETL — один из важнейших механизмов повышения доверия к данным. Главная задача ETL — не просто перенести данные из одной системы в другую, а создать информацию, которой можно доверять.
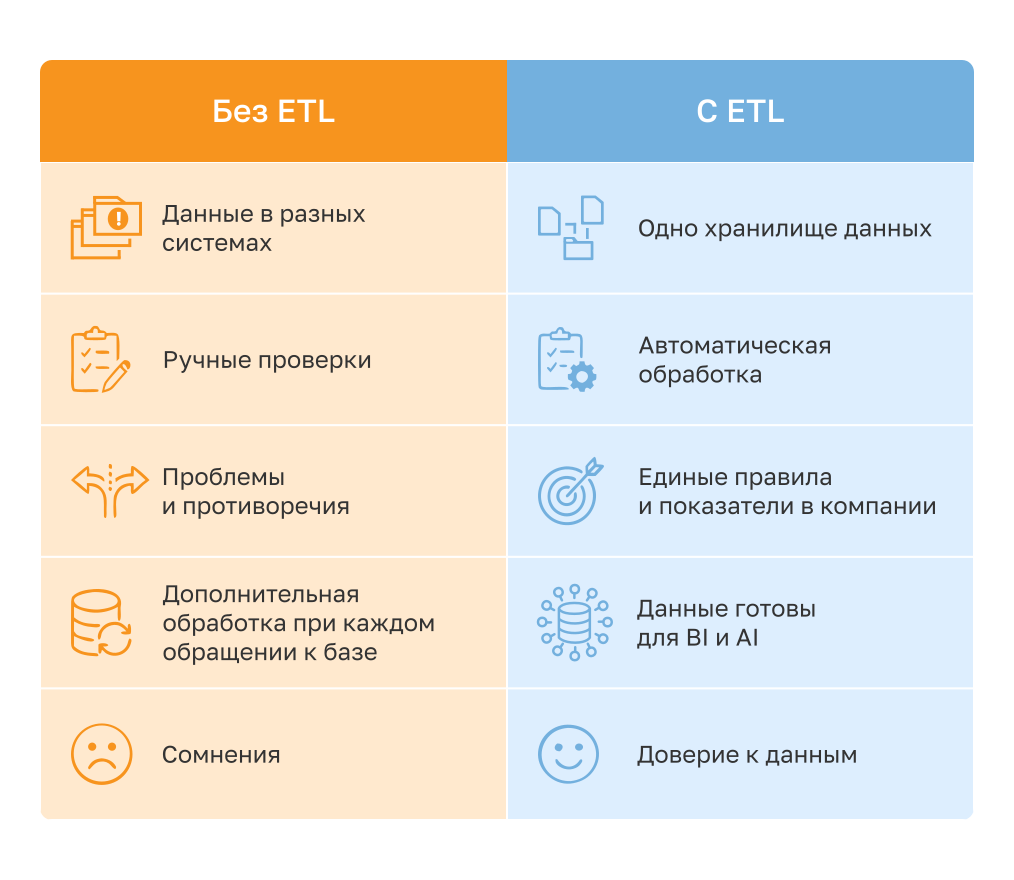
Преимущества использования ETL
ETL нужен корпоративной аналитике не потому, что без него невозможно получить данные. Данные можно извлекать с помощью SQL, обрабатывать кодом или использовать AI-инструменты. Вопрос в другом: насколько устойчивым, повторяемым и контролируемым будет этот процесс по мере роста компании.
Требования к данным не зависят от способа реализации ETL: сценарий может быть создан как в визуальном конструкторе, так и программным кодом — при условии, что процесс прозрачен, контролируем и выполняется по единым правилам.
ETL обеспечивает именно такую основу: автоматически извлекает, очищает, преобразует и документирует данные, делая каждую загрузку воспроизводимой, а происхождение каждого показателя — понятным. В результате бизнес получает не просто отчеты, а единый источник достоверной информации, на который можно опираться при принятии решений. Поэтому ценность ETL заключается не только в перемещении данных, а в создании управляемого процесса их подготовки — основы для доверия к данным, которые используются в аналитике и принятии решений.
Другие материалы по теме:
Как восстановить клиентскую базу из 5.7 млн проблемных записей
Loginom — лидер рейтинга ETL-систем 2026 по версии Компьютерры